JustBee · 人工智能模型公司
让机器看见,
并学会行动。
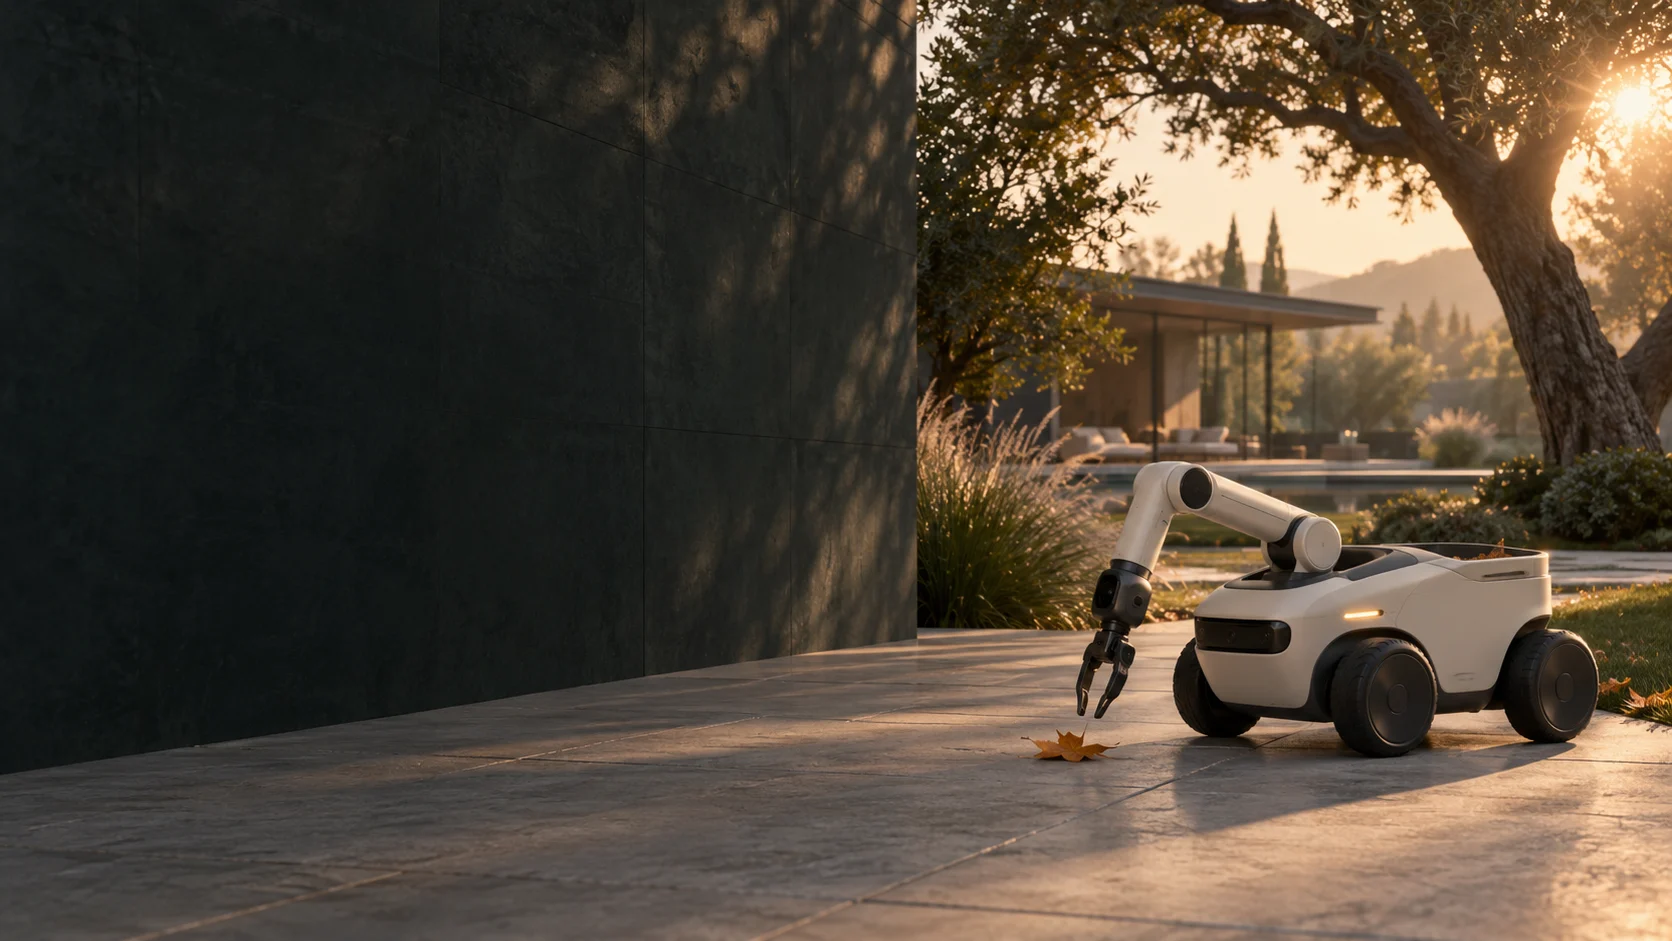
BeeMind 是我们自主研发的视觉动作模型。它将机器人所感知的画面直接转化为连贯、协调的动作,并在每一次尝试中持续精进。
BeeMind视觉动作模型多伦多研究实验室2026仿真研究阶段
概念示意图
核心模型
BeeMind
VISION–ACTION MODEL · 视觉动作模型
单一神经网络同时读取多路摄像头画面与机器人本体状态,为底盘与机械臂生成连续动作。它不依赖针对具体任务编写的规则,而是从示范、自主尝试与失败中习得能力。
多视角感知输入
连续动作生成
闭环实时修正
核心能力
感知,行动,学习。
三种能力统一于同一个模型之中,而非多个独立系统的拼接。
感知
01
多视角空间理解
融合主摄像头与腕部摄像头,同时判断目标与自身的位置。
行动
02
全身协调运动
为底盘与机械臂生成平滑的动作序列,并在运动中持续校正。
学习
03
从经验中精进
示范、尝试与反馈构成持续循环,无需为每项任务重写规则。
学习方法
BeeMind 如何学习。
在仿真环境中大量训练,以真实结果评估,并将每一次经验回馈模型。
1
示范
专家策略在仿真中完整演示任务。
2
自主尝试
模型仅凭摄像头与本体状态独立执行。
3
独立评估
独立评估器只核验一件事:目标是否真正落入收集仓。
4
迭代精进
纠正失误,每一轮都在前一轮的基础上提升。
循环往复成功的唯一标准:任务真正完成
研究进展
研究进展。
我们只发布可独立核验的结果。目前处于仿真研究阶段,尚未进行实机部署。
已完成
感知
识别目标与收集仓
进行中
接近
依据视觉驶向目标
下一阶段
接触
末端触及目标
规划中
抓取
实现稳定夹持
规划中
投放
准确放入收集仓
长期目标
跨本体迁移
拓展至新的机器人
以独立评估为准,不以模型自我报告为准更新于 2026 年 11 月 9 日 · 每两周复核
长期愿景
一个模型,
多种本体。
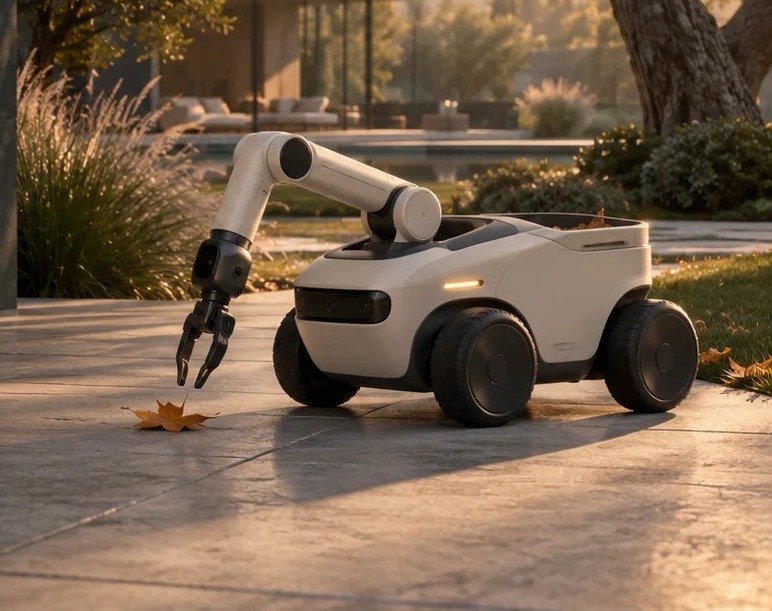
BeeMind 的设计可接收对机器人本体的描述,使同一模型未来能够学会控制新的机械臂与移动底盘。这是一项长期研究方向,正在逐步验证。
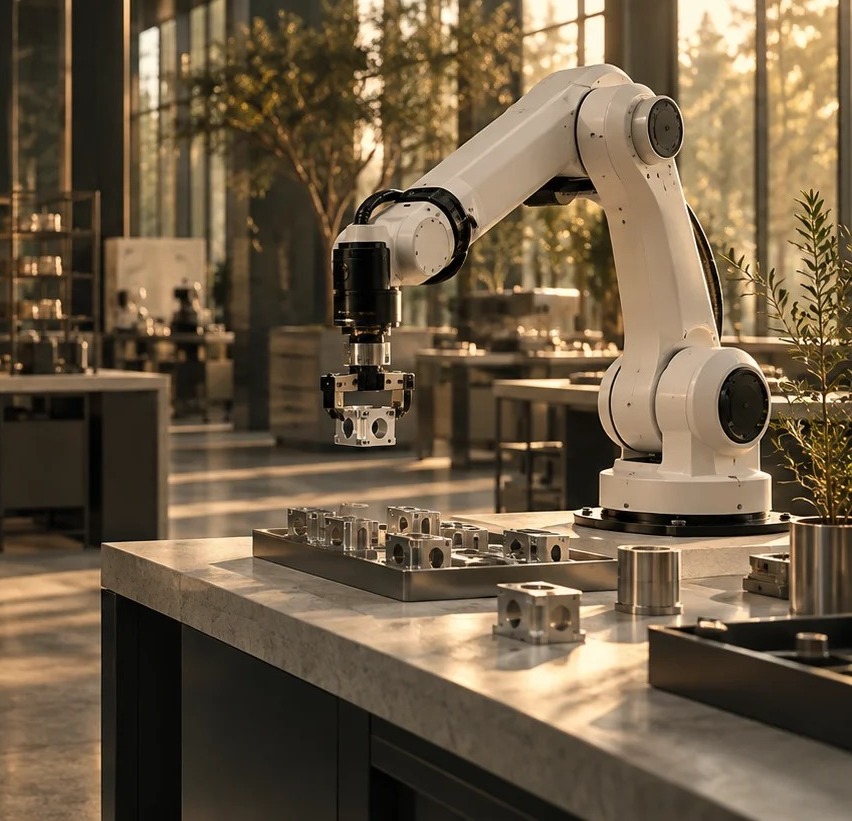
同一个 BeeMind
研究札记
研究札记。
实验室简报,至少每两周发布一篇。
更早的研究记录 +
与 JustBee 携手合作。
我们欢迎研究机构、机器人制造商与早期试点伙伴的合作。